
Автор: kodewright · Опубліковано: 2026-04-06 · Оновлено: 2026-10-20
Regex пошук і заміна — опануй пошук за шаблоном у 2026
Опануй пошук і заміну через регулярні вирази, щоб миттєво трансформувати текст. Групи захоплення, квантифікатори й патерни — практичний гайд для авторів і розробників.
Regex пошук і заміна шукає шаблон замість фіксованого рядка й переписує все, що цей шаблон знайшов. В інструменті Пошук і заміна постав галочку «Використання регулярного виразу (Regex)», впиши шаблон у поле пошуку, а заміну — в «Замінити на», і натисни «Замінити все». Частини збігу можна повторно використати в заміні як $1, $2 тощо, і саме це робить regex чимось більшим за просунутий Ctrl+F.
Уяви CSV, де дати вийшли як 2026-04-06, а таблиці потрібно 06.04.2026. Звичайний пошук тут безсилий, бо кожна дата інша. Шаблон упорається: знайти чотири цифри, дефіс, дві цифри, дефіс, ще дві цифри й повернути ці три групи у зворотному порядку.
Що насправді виконує інструмент
Інструмент передає твій шаблон нативному JavaScript RegExp браузера, тож усе нижче працює за правилами JavaScript. Я зробив його так, щоб текст і шаблон обробляла сама сторінка: нічого не відправляється на сервер, а це важливо, коли вставляєш логи чи списки клієнтів. Кілька деталей із вихідного коду, які впливають на те, як писати шаблони:
- Галочка «З урахуванням регістру» додає або прибирає прапорець
i. За замовчуванням вона вимкнена, тожcatзнаходить іCat. - «Глобальний матч» додає прапорець
gі ввімкнений за замовчуванням. Кнопка «Замінити» змінює лише перший збіг, «Замінити все» — усі. - Прапорця
mнемає, тож^і$збігаються лише з початком і кінцем усього тексту, а не кожного рядка. - Прапорця
sнемає, тож.зупиняється на переносі рядка. - Прапорця
uтеж немає. Це підставляє, і я ще повернуся до цього нижче.
Збіги підсвічуються у вхідному тексті й підраховуються біля поля пошуку. Якщо в шаблоні синтаксична помилка, замість цього з'явиться «Недійсний шаблон регулярного виразу».
| Токен | Значення | Приклад |
|---|---|---|
\d | Одна цифра (0-9) | \d{3} збігається з «123» |
\w | Один із символів A-Z, a-z, 0-9, _ (лише ASCII) | \w+ збігається з «Hello_World» |
\s | Пробільний символ: пробіл, табуляція, перенос рядка | \s{2,} знаходить серії пробілів |
\S | Будь-що, крім пробільного символу | \S+ збігається з «José» чи «Іван» |
. | Будь-який символ, крім переносу рядка | c.t збігається з «cat», «cut», «c9t» |
+ | Один або більше попередніх елементів | \d+ збігається з «1» і «1000» |
* | Нуль або більше попередніх елементів | ba* збігається з «b», «ba», «baaa» |
\b | Межа слова | \bthe\b пропускає «there» |
^ / $ | Початок / кінець тексту | ^Start збігається лише на самому початку |
Групи захоплення
Усе, що стоїть у дужках, запам'ятовується, а поле заміни може викликати це як $1, $2 у порядку відкриваючих дужок.
Для дат вище:
- Знайти:
(\d{4})-(\d{2})-(\d{2}) - Замінити на:
$3.$2.$1
Я запустив це в Node на 2026-04-06 і отримав 06.04.2026. Той самий трюк переставляє імена. Для списку рядків «Ім'я Прізвище»:
- Знайти:
(\S+)\s(\S+) - Замінити на:
$2, $1
John Smith, Іван Петренко і José García перетворюються на Smith, John, Петренко, Іван і García, José. Коли список має такий вигляд, Сортувати рядки розкладе його за абеткою за прізвищем, а якщо джерело було набране капсом, Зміна регістру потім виправить регістр.
\S+ я взяв навмисно. Очевидний вибір для «літер» — \w+, але \w лише для ASCII, тож він упорається з John і зовсім пропустить Іван (і José теж, бо é немає в A-Z). Правильне юнікодне рішення — \p{L}+, але воно працює лише з прапорцем u. Я спробував (\p{L}+)\s(\p{L}+) з тими самими прапорцями, що й в інструменті (gi), і збігів не було, причому без жодної помилки: текст просто лишився без змін. У власному JavaScript додай прапорець u (/(\p{L}+)\s(\p{L}+)/giu працює). В цьому інструменті бери \S+ або клас символів на кшталт [^\s,]+.
Поле заміни розуміє також $& (весь збіг) і іменовані групи: (?<last>\S+) можна вставити як $<last>.
Жадібні й ліниві квантифікатори
* і + жадібні: вони беруть скільки можуть і віддають лише те, що потрібне решті шаблону. Це вилазить, щойно ти вперше пробуєш вирізати HTML через <.*>.
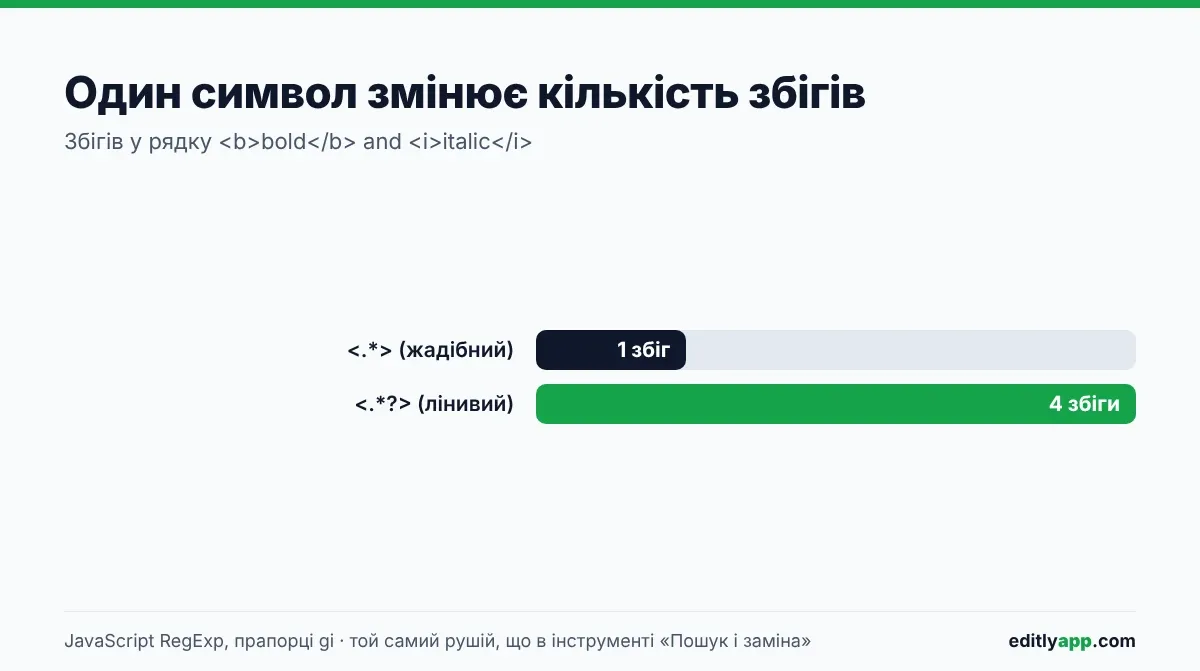
Запусти його на <b>bold</b> and <i>italic</i> і отримаєш один збіг, увесь рядок, бо жадібне .* біжить до останнього > у рядку. Додай знак питання, і воно стане лінивим:
- Жадібний:
<.*>знаходить 1 збіг - Лінивий:
<.*?>знаходить 4 збіги:<b>,</b>,<i>,</i>
Оскільки . не перетинає перенос рядка, шкода від жадібного шаблону обмежується одним рядком. У документі, де кожен тег на окремому рядку, <.*> зітре кожен рядок окремо, а не проковтне весь файл. Для втрати потрібного вмісту цього все одно досить, тож спершу перевіряй на малому зразку. Якщо треба лише навести лад із пробілами, Виправити пробіли робить це без написання шаблонів.
Шаблони для авторів і редакторів
Подвійні пробіли після крапки
- Знайти:
\. {2,} - Замінити на:
.
(У заміні після крапки стоїть пробіл.) Це ловить і три та більше пробілів, які шаблон із рівно двома пробілами залишає частково. На тестовому рядку з двопробільним і трипробільним проміжками {2,} виправив обидва, а версія з рівно двома лишила трипробільний проміжок як два пробіли.
Кандидати на пасивний стан
- Знайти:
\b(am|is|are|was|were|been|being)\s\w+ed\b
Regex не читає граматику, тож сприймай підсвічене як список для перевірки. Він знаходить «was invited», «is fixed» і «been reviewed». Він пропускає неправильні дієприкметники на кшталт «is written» чи «was caught» і хибно спрацьовує на прикметниках типу «is red». Якщо мета — коротша чернетка, у статті як скоротити кількість слів розписано, що різати, коли слабкі місця вже знайдено.
Повторювані слова
- Знайти:
\b(\w+)\s+\1\b - Замінити на:
$1
\1 усередині шаблону означає «той самий текст, що щойно зловила група 1». На «This is is a test, the the end» лишається «This is a test, the end». Він також зливає законні повтори на кшталт «had had», тож перед «Замінити все» глянь на кількість збігів. Після цього встав результат у Лічильник слів, щоб побачити нову кількість слів.
Шаблони для розробників
Вирізання HTML-тегів
- Знайти:
<[^>]+> - Замінити на: (залиш порожнім)
Я б брав його замість <.*?>, і причина в переносах рядків. Тег, розірваний між двома рядками, як-от <a і далі href="x">, <.*?> пропустить, бо . зупиняється на переносі, а [^>] переноси матчить і впіймає його. Обидві версії мають одну спільну слабкість: атрибут із буквальним >, наприклад alt="Score > 90", достроково обриває збіг і лишає 90" src="x.png">. Для довільного HTML regex — не той інструмент. На чистій розмітці він годиться, а для чогось безладного бери парсер.
Коли теги зникнуть, Лічильник слів покаже кількість слів видимого тексту, а не розмітки.
Бектрекінг може заморозити вкладку
Вкладені квантифікатори можуть змусити рушій перебирати експоненційну кількість комбінацій. У Node /(a+)+b/ на 26 літерах a без b відпрацював близько 3,7 секунди. Інструмент виконує regex в основному потоці сторінки, без воркера, тож такий шаблон заблокував би вкладку, доки не завершиться. Якщо сторінка перестала відповідати, перший підозрюваний — вкладене (x+)+ або (x*)*.
Регістр, глобальний збіг і якорі
Якщо шукаєш назву змінної в коді, став галочку «З урахуванням регістру». Для слова в прозі лиши її вимкненою, інакше пропустиш кожне входження з великої літери на початку речення. «Глобальний матч» тримай увімкненим для масових правок, а вимикай, коли хочеш перевірити ризикований шаблон лише на першому збігу.
Оскільки прапорця m немає, ^Start на тексті з двох рядків змінює лише перший. Я перевірив це на Start here і Start there: лише перший став X. Якщо потрібні якорі для кожного рядка, використай інше середовище або не користуйся якорями, а зачепися за те, що оточує текст.
Якщо ти прийшов із Word
«Використовувати символи підстановки» у Word — це не regex: там [0-9] замість \d, < і > для меж слова, @ для «один або більше» і \1 у заміні там, де JavaScript має $1. Шаблони, перенесені між ними, зазвичай просто не спрацьовують. У статті Пошук і заміна тексту оптом без Word обидва синтаксиси зіставлено, а ще там розібрано проблему невидимих символів, через яку однаково виглядний текст не збігається.
Стандарти
Інструмент використовує JavaScript-різновид regex (ECMAScript). Він подекуди відрізняється від регулярних виразів POSIX і від PCRE у стилі Perl, тож шаблон, скопійований із grep чи однорядкового скрипта Perl, може потребувати правок. Посібник MDN із регулярних виразів — довідник, до якого заглядаю я сам, зокрема щодо lookahead і прапорців.
Часті запитання
Regex складно вивчити?
Синтаксис виглядає непривітно, але робочий набір невеликий. Буквальний текст, \d, \s, ., +, * і дужки закривають більшість редакторських задач. Вивчи їх, а решту гугли, коли знадобиться.
Чи підтримує інструмент зворотні посилання?
У полі заміни так: $1, $2, $& та $<name> для іменованих груп. Усередині шаблону працює і \1, саме так шаблон повторюваних слів вище знаходить здвоєне слово.
Чи сповільнить regex мій браузер?
Рідко. Для звичайних шаблонів на звичайному тексті заміна швидка. Гальма дають вкладені квантифікатори з інтенсивним бектрекінгом, як у прикладі вище, а в інструмента немає воркера, щоб винести це зі сторінки.
Як знайти буквальну крапку чи дужку?
Постав перед нею зворотний слеш. \. збігається зі справжньою крапкою, \[ зі справжньою відкриваючою квадратною дужкою, \( з круглою. Без слеша . збігається з будь-яким символом.
Чи може regex знаходити номери телефонів?
Простий американський шаблон — \d{3}-\d{3}-\d{4}, але він ловить лише 555-123-4567. Цей упорається також із (555) 123-4567, 555.123.4567 і 555 123 4567: \(?\d{3}\)?[-.\s]?\d{3}[-.\s]?\d{4}. Я перевірив усі чотири формати. Він свідомо вільний, тож інколи буде хибне спрацювання на довгих рядках цифр.
Якщо ти підганяєш чернетку під ліміт за допомогою цих шаблонів, стаття скільки слів на сторінці підкаже, що твоя кількість слів означає в сторінках.