
Автор: kodewright · Опубліковано: 2026-05-08 · Оновлено: 2026-11-04
Як прибрати зайві пробіли з тексту онлайн (швидкий фікс)
Встав текст і прибери подвійні пробіли, нерозривні пробіли та зайві розриви рядків з PDF за секунди. Безкоштовно, у браузері, без завантаження файлів.
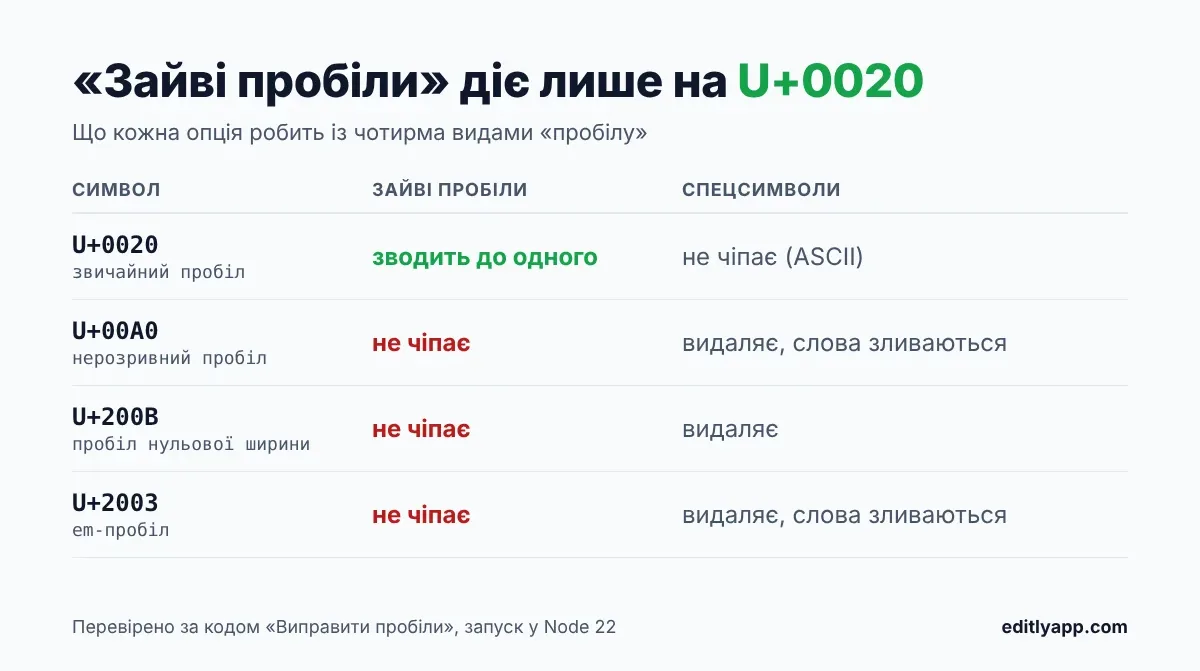
Встав текст у Виправити пробіли, познач «Прибрати зайві пробіли» і скопіюй результат. Кожна серія звичайних пробілів стане одним пробілом, а краї тексту будуть обрізані. Нерозривні пробіли, табуляції та символи нульової ширини ця опція не чіпає, і саме тут ховається причина більшості скарг «я прибрав пробіли, а частина лишилась».
Я зробив інструмент так, щоб очищення відбувалося у вкладці твого браузера. Нічого не вивантажується: з того боку просто немає сервера, який міг би зберегти копію.
Що робить кожна опція
Опцій сім. Вони комбінуються, а попередній перегляд показує зміни ще до копіювання. Опис нижче я звіряв із кодом інструмента, бо кілька опцій поводяться не так, як натякають їхні назви.
| Опція | Що робить | Приклад (· — пробіл, ↵ — розрив рядка) |
|---|---|---|
| Прибрати зайві пробіли | Зводить кожну серію звичайних пробілів до одного й обрізає початок і кінець усього тексту | word··word → word·word |
| Виправити розриви PDF | Перетворює поодинокі розриви рядків усередині абзацу на пробіли, а порожні рядки між абзацами лишає | quick·brown↵fox → quick·brown·fox |
| Прибрати всі розриви рядків | Замінює кожен розрив рядка пробілом | line·1↵line·2 → line·1·line·2 |
| Прибрати порожні рядки | Видаляє кожен порожній рядок, тож абзаци опиняються в сусідніх рядках | para↵↵↵para → para↵para |
| Обрізати кінці рядків | Прибирає пробіли наприкінці кожного рядка; початкові лишаються | hello··↵ → hello↵ |
| Видалити спецсимволи | Видаляє кожен не-ASCII символ | résumé → rsum |
| Випрямити лапки | Кучеряві лапки стають прямими | “hi” → "hi" |
Дві речі варто знати, перш ніж ставити позначки. «Виправити розриви PDF» не лагодить переноси: infor-↵mation стане infor- mation. А «Видалити спецсимволи» разом з усім іншим прибирає й літери з діакритикою, тож не застосовуй його до німецького, французького чи українського тексту.
Звідки в тексті зайві пробіли
PDF зберігає літери як координати, а не як слова. Коли ти копіюєш звідти, рідер вгадує початок слів за проміжками між гліфами, а вирівняні по ширині або розріджені рядки можуть штовхнути здогад у бік двох пробілів. Друге типове джерело — копіювання з відрендереної вебсторінки: у HTML подекуди стоїть , і до буфера обміну воно потрапляє як U+00A0. У Word теж є комбінація для нерозривного пробілу (Ctrl+Shift+Space), і я допускаю, що деякі шаблони її використовують.
На екрані жоден із них не відрізняється від звичайного пробілу. Через це вони проявляються лише згодом: у кількості слів, у пошуку чи в регулярці, що не збігається.
Символи, схожі на пробіли
| Символ | Код | Прибрати зайві пробіли | Чи ловить \s у JavaScript |
|---|---|---|---|
| Звичайний пробіл | U+0020 | Зводить до одного | Так |
| Нерозривний пробіл | U+00A0 | Не чіпає | Так |
| Тонкий пробіл | U+2009 | Не чіпає | Так |
| Em-пробіл | U+2003 | Не чіпає | Так |
| Пробіл нульової ширини | U+200B | Не чіпає | Ні |
Остання колонка здивувала мене, коли я це запустив. У багатьох матеріалах стверджують, що \s пропускає нерозривний пробіл, але в сучасному JavaScript він збігається. Крізь усі патерни з \s проскакує якраз пробіл нульової ширини.
Що ламають нерозривні пробіли та пробіли нульової ширини
Я прогнав рядок "New\u00A0York" через Intl.Segmenter у Node 22 і отримав два слова, так само як зі звичайним пробілом. Лічильник слів на цьому сайті використовує той самий API, тож випадковий нерозривний пробіл його підрахунку не змінює. Інакше з кодом, що ділить за буквальним пробілом: "New\u00A0York".split(' ') повертає один елемент.
Пробіли нульової ширини підступніші. Ширини в них немає, тож редактори нічого не показують, але регулярка на кшталт /\s+/ не вважає їх пробільними символами, а порівняння рядків бачить два різні рядки.
У моїй роботі безладні пробіли здебільшого приходять із логів, CSV-файлів і користувацького вводу в застосунках, а не з документів Word. Одного разу я також наступив на баг, спричинений нерозривним пробілом у коді чи даних. Такі самі невидимі символи трапляються й під час вставки з PDF, про що я згадував у статті скільки слів на сторінці.
Виправлення через регулярки в «Пошуку і заміні»
Опції «Виправити пробіли» не перетворюють нерозривні пробіли й пробіли нульової ширини, тож для них я перемикаюся на Пошук і заміна з увімкненим Regex. Інструмент дозволяє налаштувати лише регістр і глобальний збіг, тому патернам нижче прапорці не потрібні. Запускай їх у такому порядку:
- Знайди
[\u00A0\u2000-\u200A], заміни на один пробіл. Це нерозривний пробіл і весь блок U+2000–U+200A (en-пробіл, em-пробіл, тонкий пробіл тощо). - Знайди
\u200B, поле заміни лиши порожнім. Пробіли нульової ширини зникнуть. - Знайди
[ \t]+, заміни на один пробіл. Це зводить серії пробілів і табуляцій, не чіпаючи розривів рядків. - Знайди
(?<=[^\n])\n(?=[^\n]), заміни на пробіл. Так склеюються розриви посеред абзацу з PDF, а порожні рядки між абзацами лишаються.
Для кроку 3 не бери \s+: воно ловить і переноси рядків, тож абзаци злипнуться в один блок. Повний синтаксис патернів, групи захоплення та квантифікатори розібрано в гайді з пошуку й заміни регулярками.
Порядок важливий. Якщо спочатку звести пробіли, нерозривний пробіл поруч зі звичайним уціліє, а крок 1 знову залишить тобі подвійний пробіл.
Коли не можна прибирати пробіли
На прозі очищення безпечне, а на всьому, де відступ щось означає, руйнівне. «Прибрати зайві пробіли» зводить до одного й початкові пробіли, тож відступ із чотирьох пробілів стане одним.
У Python відступи і є структурою блоків, тож ти отримаєш або IndentationError, або, що гірше, інструкції, які тихо вилетять зі свого циклу. У YAML ключі вкладаються початковими пробілами, тому чистка може перепідпорядкувати ключ і лишити валідний файл, який означає вже щось інше. У Markdown чотири початкові пробіли роблять блок коду, а два кінцеві — жорсткий розрив рядка, тож «Обрізати кінці рядків» непомітно перекомпонує абзаци. У TSV роздільниками стовпців є табуляції, а у файлі патча формат — це початковий пробіл, + і -.
У таких файлах роби потрібну одну зміну точною регуляркою, а решту не чіпай.
Швидка діагностика перед очищенням
- Пошукай два пробіли поспіль. Збіги означають подвійні пробіли.
- Увімкни Regex у «Пошуку і заміні» й знайди
\u00A0. Збіги означають нерозривні пробіли. - Знайди
\u200B, щоб виявити пробіли нульової ширини. - Пошукай рядки, що обриваються посеред речення. Це проблема розривів із PDF.
Потім познач лише потрібні опції. Панель попереднього перегляду покаже результат до копіювання.
Коли текст уже чистий
Очищення зазвичай іде першим кроком більшої роботи. Коли кінцеві пробіли зникли, apple· і apple стають рівними, тож роби це до того, як сортувати рядки за алфавітом, де порядок можуть змінити ще й регістр та локаль.
Невидимі символи також часто дають хибні відмінності в diff: два рядки виглядають однаково, а показані як змінені, бо один закінчується нерозривним пробілом або CRLF. Спершу очисти обидві версії, а тоді порівняй два текстові файли онлайн.